Replica Set을 구축했다면 그다음 할 일은 "정말로 장애가 났을 때 자동으로 넘어가는지" 직접 확인하는 것입니다. 설정만 해두고 실제로 장애를 주입해보지 않은 상태로 운영에 들어가는 것은 위험합니다. 이 글에서는 Primary 장애를 인위적으로 재현하는 여러 방법과, 그 과정에서 관찰해야 할 지표, 그리고 흔히 간과하는 Rollback 리스크까지 정리합니다.
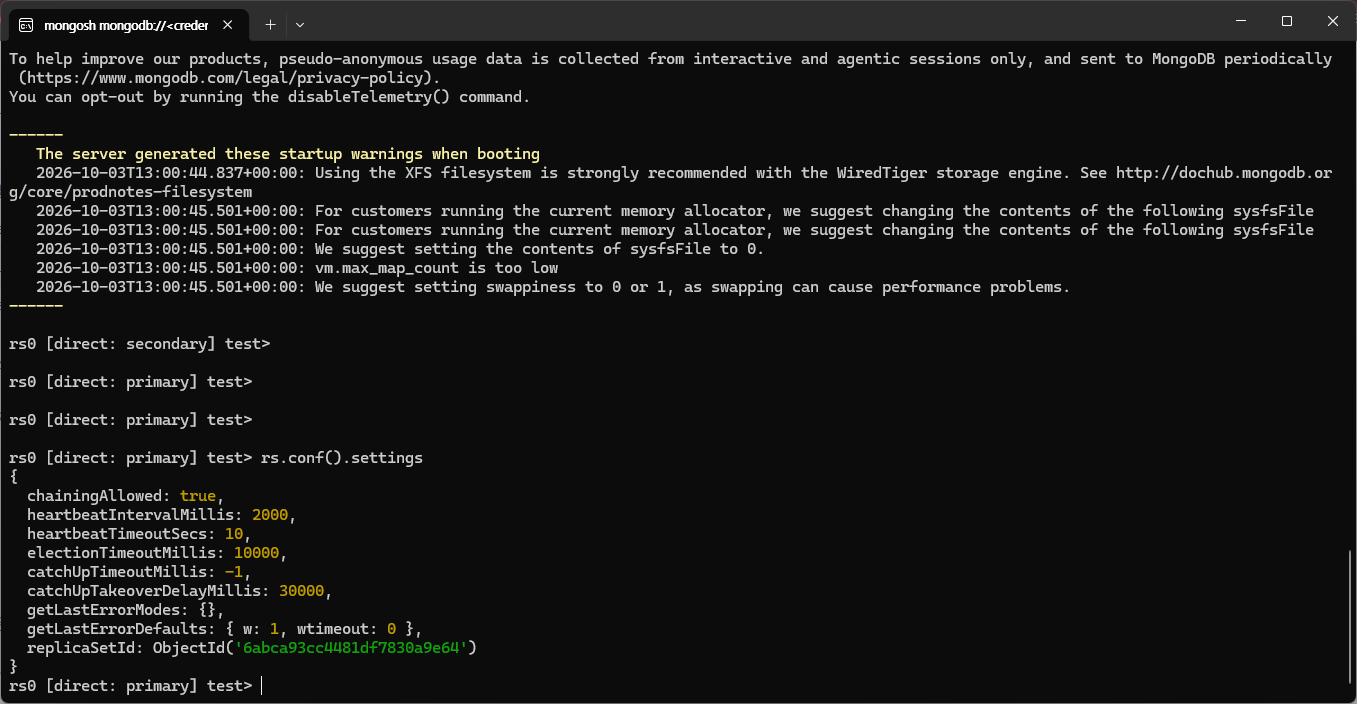
1. Failover 테스트 전에 알아야 할 타이머 값
MongoDB의 자동 Failover는 정해진 타이머에 따라 동작합니다. 테스트 결과를 해석하려면 이 값들을 먼저 알아야 합니다.
| 설정값 | 기본값 | 의미 |
| heartbeatIntervalMillis | 2000ms (2초) | 멤버 간 하트비트 전송 주기 |
| electionTimeoutMillis | 10000ms (10초) | Primary의 하트비트 응답이 이 시간 동안 없으면 선출 트리거 |
| catchUpTimeoutMillis | -1 (무제한, 최근 버전은 자동 계산) | 새로 선출된 Primary가 이전 Primary의 최신 oplog까지 따라잡을 시간 |
즉, 이론적으로 장애 발생부터 새 Primary 확정까지 최소 10초 안팎의 다운타임이 발생할 수 있다는 뜻입니다. 이 숫자를 미리 알고 테스트해야 "생각보다 오래 걸리는데?"라는 오해를 피할 수 있습니다.
현재 상태 확인
2. 장애를 재현하는 4가지 방법
같은 "Primary 장애"라도 재현 방법에 따라 감지 속도와 애플리케이션 체감이 다릅니다.
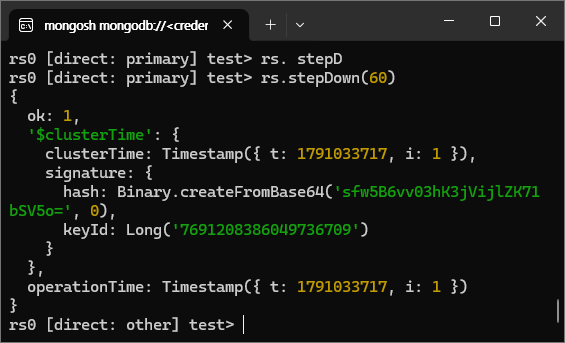
방법 1 — rs.stepDown() (정상 종료에 가까운 graceful 전환)
이 명령어는 primary 노드에서만 유효하다고 한다.
// 현재 PRIMARY에 접속한 상태에서
rs.stepDown(60)   // 60초간 재선출 후보에서 스스로 제외
Primary가 스스로 "나 잠깐 빠질게"라고 알리고 물러나는 방식이라, 전환이 가장 빠르고 매끄럽습니다. 배포·패치처럼 계획된 유지보수에 실제로 사용하는 명령이기도 합니다.
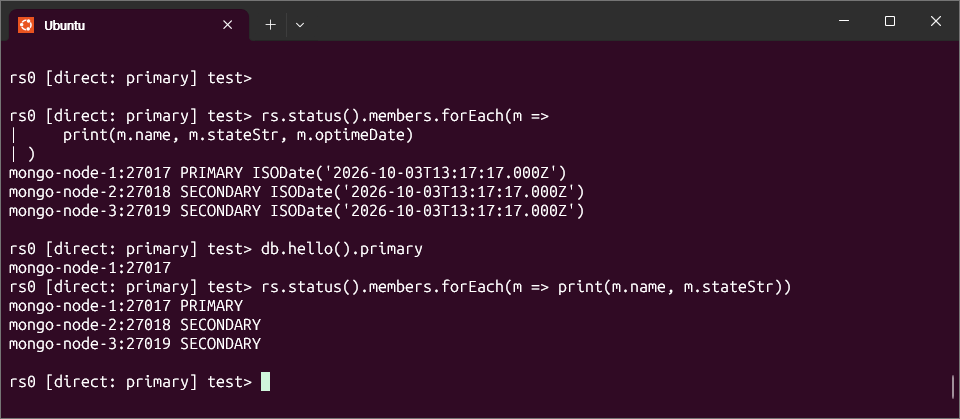
1.1 현재 Replica Set 상태
1.2 정상종료
1.3 노드1의 로그에서 stepdown과 election node 2가 선출되었음.

1.4 노드2가 primary로 변경되었음
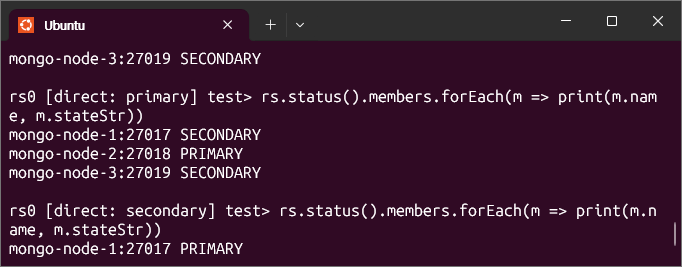
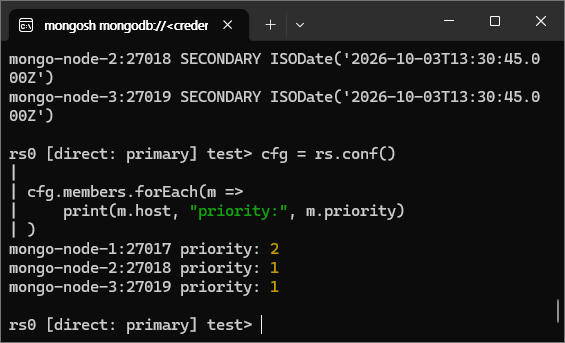
그리고 나서 다시 primary가 노드1이 되었는데 이건 확인해보니까 우선순위 설정을 노드1로 해놓은것 때문이였음.
방법 2 — 프로세스 강제 종료 (kill -9, 가장 현실적인 장애 재현)
# node-1 서버에서
sudo kill -9 $(pgrep mongod)
디스크 장애, OOM Kill 등 실제 운영 장애와 가장 유사한 형태입니다. 하트비트가 완전히 끊기므로 electionTimeoutMillis를 온전히 기다려야 새 Primary가 나옵니다.
프로세스 강제종료 대신에 docker를 내리겠음.
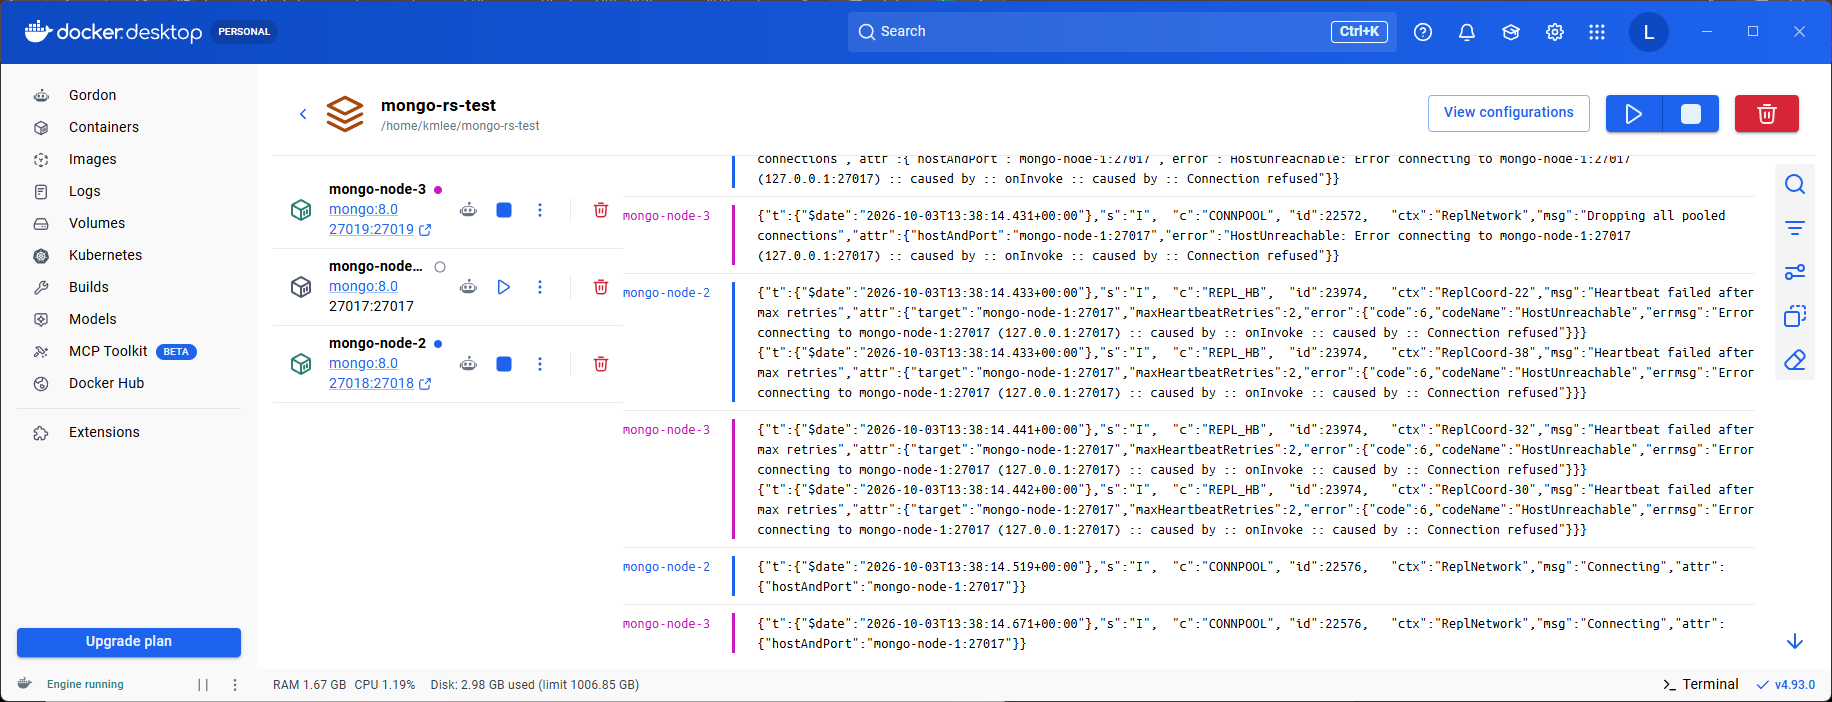
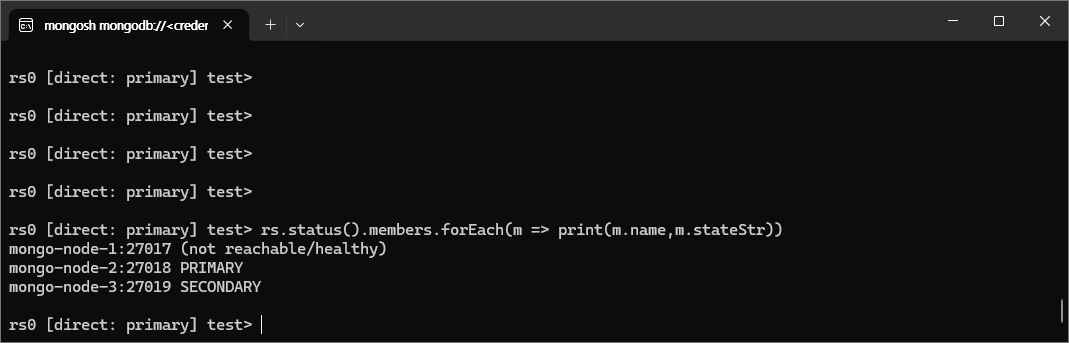
2-1 노드 2에서 현재 프라이머리 확인하니 노드 1은 헬스체크 불가능 상태
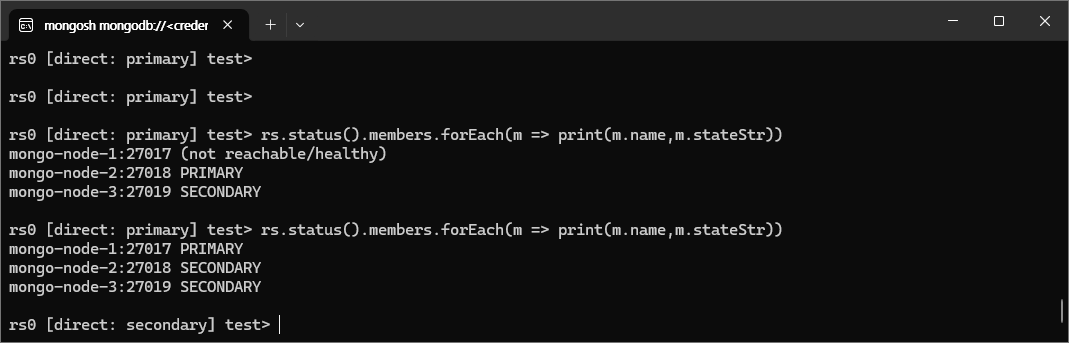
2-2 노드1 기동해주니 다시 primary로 기동되었음
3. 테스트 절차와 관찰 포인트
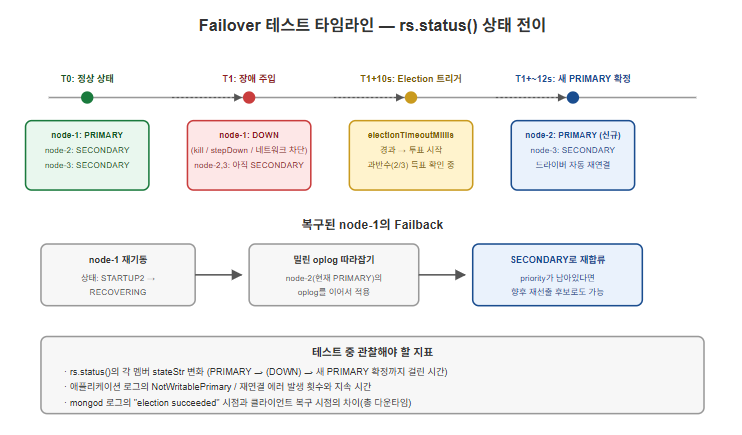
- 사전 상태 확인: rs.status()로 현재 Primary/Secondary 구성을 기록해둡니다.
- 부하 발생: 테스트 중에도 지속적으로 쓰기가 들어가도록 간단한 반복 삽입 스크립트를 돌려둡니다 (에러 발생 여부와 지속 시간을 측정하기 위함).
- 장애 주입: 위 4가지 방법 중 하나를 Primary에 적용합니다.
- 다른 노드에서 상태 관찰:
// node-2 또는 node-3에서 반복 실행
rs.status().members.forEach(m => print(m.name, m.stateStr))
전환 과정에서 상태가 대략 이렇게 바뀌는 것을 볼 수 있습니다.
node-1  PRIMARY   →  (DOWN 또는 응답 없음)
node-2  SECONDARY →  SECONDARY →  PRIMARY
node-3  SECONDARY →  SECONDARY (유지)
- 로그 확인: mongod.log에서 선출 관련 메시지를 확인합니다.
grep -i "election" /var/log/mongodb/mongod.log
# "Starting an election", "election succeeded" 등의 라인 확인
- 애플리케이션 쪽 에러 확인: 이 구간 동안 드라이버가 던지는 에러(NotWritablePrimary, NotPrimaryNoSecondaryOk 등)와 그 지속 시간을 기록합니다. 최신 드라이버는 Retryable Writes가 기본 활성화되어 있어, 짧은 Failover 구간의 쓰기 실패를 드라이버가 자동으로 한 번 재시도해주기도 합니다.
4. 반드시 짚어야 할 함정: Rollback
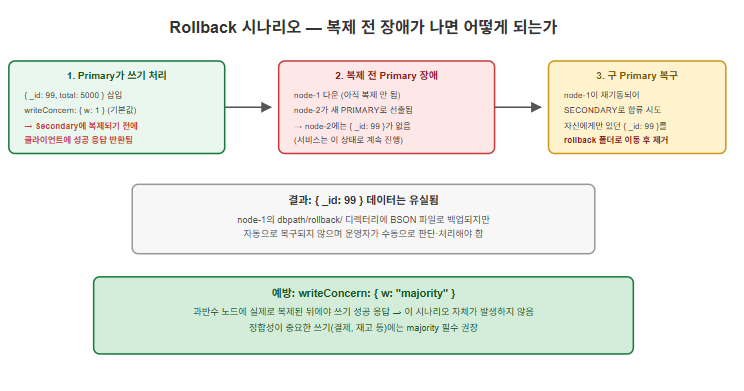
Failover 테스트에서 가장 많이 간과하는 부분이 이것입니다. 기본 writeConcern(w: 1)으로 쓰기를 하면, Primary 한 곳에만 기록되고 Secondary로 복제되기 전에 클라이언트에 성공 응답이 돌아갑니다. 만약 바로 그 직후에 Primary가 죽고 다른 노드가 새 Primary로 선출되면, 새 Primary에는 그 데이터가 없는 상태로 서비스가 계속됩니다.
이후 죽었던 구 Primary가 복구되어 Secondary로 재합류할 때, MongoDB는 "새 Primary의 oplog 기준에 없는, 자신에게만 있던 쓰기"를 찾아내 **자동으로 롤백(제거)**합니다. 이 데이터는 완전히 사라지는 것은 아니고 dbpath 아래 rollback 디렉터리에 BSON 파일로 남지만, 자동으로 복구되지 않으며 운영자가 직접 확인하고 처리해야 합니다.
# 롤백된 데이터가 남는 위치 (버전에 따라 경로가 다를 수 있음)
ls /var/lib/mongo/rollback/
예방책
db.orders.insertOne(
  { user_id: "u1", total: 45000 },
  { writeConcern: { w: "majority", wtimeout: 5000 } }
)
w: "majority"를 쓰면 과반수 노드에 실제로 복제된 뒤에야 성공 응답이 오므로, 애초에 롤백될 데이터 자체가 생기지 않습니다. Failover 테스트를 할 때는 반드시 w: 1과 w: "majority" 두 가지 writeConcern으로 각각 테스트해서 차이를 눈으로 확인해보는 것을 권장합니다.
5. Failback — 복구된 노드는 어떻게 되나
죽었던 node-1이 다시 살아나면, 자동으로 클러스터에 재합류를 시도합니다.
- STARTUP2 상태로 시작
- 자신에게만 있던 미복제 쓰기가 있다면 위에서 설명한 롤백 수행
- RECOVERING 상태로 전환되어, 현재 Primary(node-2)의 oplog를 이어서 따라잡음
- 따라잡기가 끝나면 SECONDARY로 전환되어 정상 합류
rs.status()
// node-1의 stateStr이 "RECOVERING" → "SECONDARY"로 바뀌는 것을 확인
priority를 원래대로 유지했다면 node-1은 이후 다시 Primary 후보가 될 수 있습니다. 특정 노드를 계속 Primary로 유지하고 싶지 않다면(예: 성능이 낮은 DR 사이트 노드), priority: 0으로 낮춰두는 것도 방법입니다.
6. 프로덕션 배포 전 체크리스트
- [ ] rs.stepDown() 기반의 계획된 전환 테스트 — 다운타임이 수 초 이내인지 확인
- [ ] kill -9 기반의 비정상 종료 테스트 — electionTimeoutMillis 근처의 다운타임인지 확인
- [ ] 네트워크 파티션 테스트 — 구 Primary가 스스로 물러나는지(split-brain 없는지) 확인
- [ ] w: 1과 w: "majority" 각각에서 데이터 유실(Rollback) 여부 비교
- [ ] 애플리케이션의 재연결/재시도 로직이 Failover 구간을 정상적으로 흡수하는지 확인
- [ ] 복구된 노드가 RECOVERING → SECONDARY로 정상 합류하는지, 소요 시간은 어느 정도인지 측정
7. 정리
- Failover 소요 시간은 electionTimeoutMillis(기본 10초)에 크게 좌우되며, 정상 종료(stepDown)와 비정상 종료(kill -9)는 체감 다운타임이 다릅니다.
- 네트워크 파티션 상황에서는 구 Primary가 과반수 하트비트를 받지 못하면 스스로 물러나 스플릿 브레인을 방지합니다.
- writeConcern: { w: 1 }로는 복제 전 장애 시 데이터가 Rollback으로 유실될 수 있으며, w: "majority"가 이를 예방하는 핵심 설정입니다.
- 복구된 노드는 STARTUP2 → (Rollback) → RECOVERING → SECONDARY 순서를 거쳐 재합류합니다.
- 실제 장애 대응 능력은 설정값을 아는 것만으로는 검증되지 않으며, 반드시 여러 시나리오로 직접 장애를 주입해 다운타임과 데이터 정합성을 눈으로 확인해봐야 합니다.
'Mongo > 운영' 카테고리의 다른 글
| MongoDB Read Preference / Write Concern 테스트 (0) | 2026.10.04 |
|---|